调用大模型接口实现文本解析
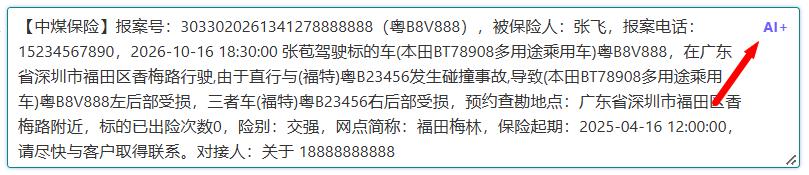
前面我们讲到了《调用大模型接口实现证件识别》,而大模型还可以做很多事情,比如最常见的就是保险公估行业,往往保司给公估师委派案件的时候会发送一条长长的短息,大体上格式如下:
【xx保险】报案号:8088020261104123456789(粤B8V888),被保险人:张飞,报案电话:15234567890,2026-10-16 18:30:00 张苞驾驶标的车(本田BT78908多用途乘用车)粤B8V888,在广东省深圳市福田区香梅路行驶,由于直行与(福特)粤B23456发生碰撞事故,导致(本田BT78908多用途乘用车)粤B8V888左后部受损,三者车(福特)粤B23456右后部受损,预约查勘地点:广东省深圳市福田区香梅路附近,标的已出险次数0,险别:交强,网点简称:福田梅林,保险起期:2025-04-16 12:00:00,请尽快与客户取得联系。对接人:关于 18888888888
那么公估公司调度人员接到信息后,需要自己拆分这段文字填入案件表单的对应字段中。现在对接了大模型,这一步就完全可以调用大模型实现了。
1、修改配置文件:config/application.yml 设置大模型,设置vision-model参数如下(如果已经设置了请忽略):
ai:
  api:
    url: https://api.deepseek.com/chat/completions
    key: 这里填deepseek的key,可在上面注释这里的网址中创建APIkey后填入
    model: deepseek-v4-pro
    # 识图 / OCR 专用模型。deepseek-v4-pro 是纯文本模型,不接受图片输入;
    # DeepSeek 官方支持图像理解的是 deepseek-flash(模型版本 DeepSeek-V4.1-Flash-1017)。
    # 依据:api-docs.deepseek.com/zh-cn/quick_start/pricing 的「图像理解」一行。
    vision-model: deepseek-flash
2、在E6开发平台中打开对应的表单,找到要填写这一大段文本的这个输入框,设置属性:
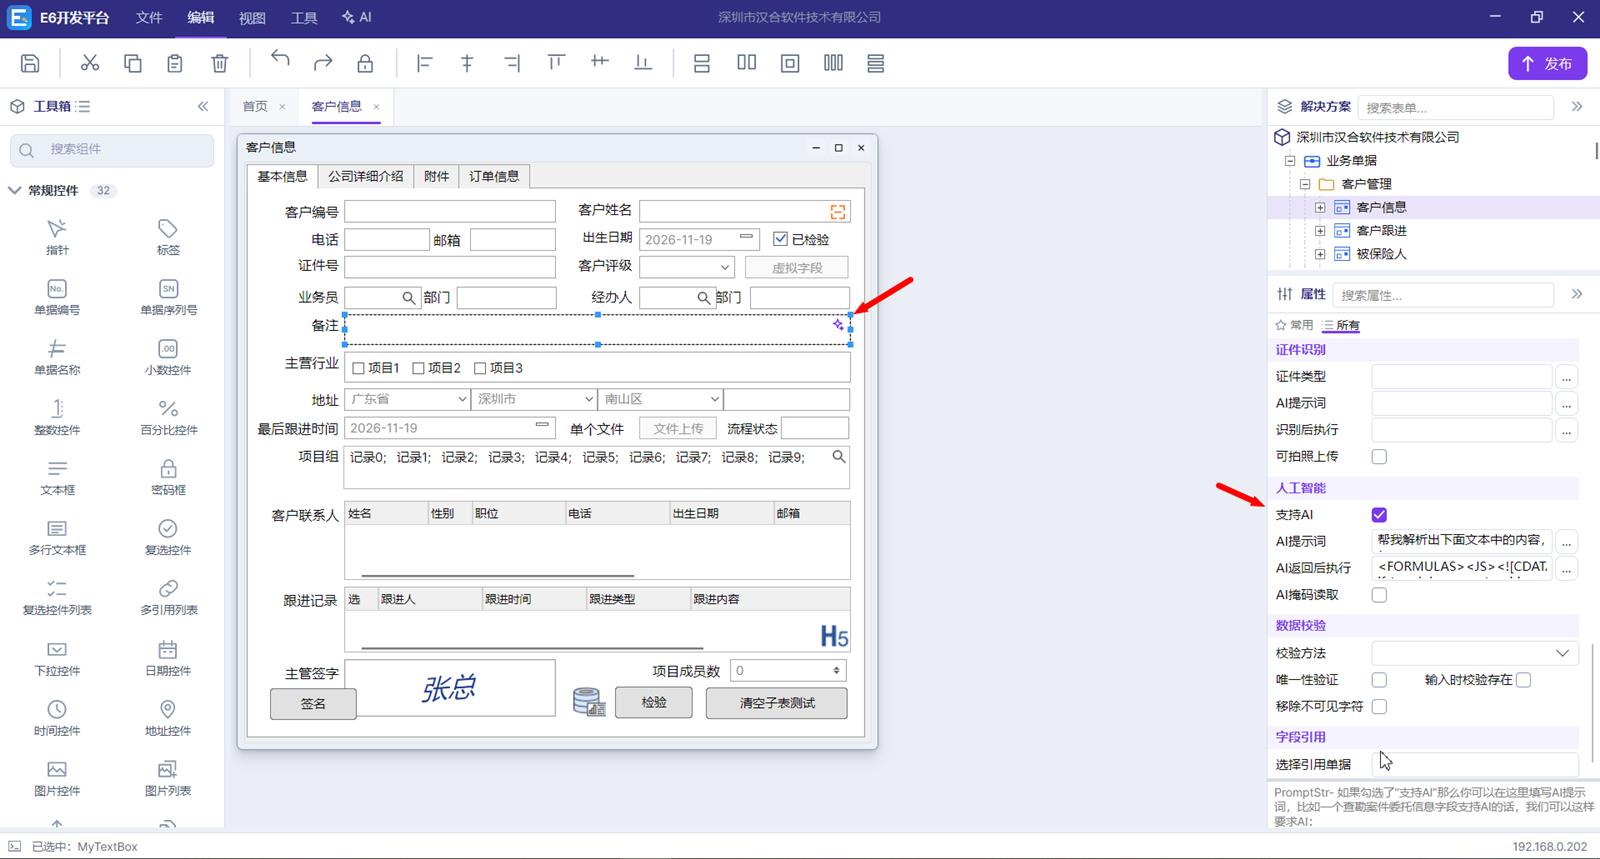
支持AI:勾选;
AI提示词:点击后面的按钮,设置为:
帮我解析出下面文本中的内容,并返回如下结构信息,不存在的信息不用返回:
{
    baoanhao: "报案号",
    baoanren: "报案人",
    jiashiren: "驾驶人",
    chuxianshijian: "出险时间",
    chuxiandidian: "出险地点",
    biaodichepai: "标的车牌",
    lianxirendianhua: "联系人电话",
    xianzhong: "险种类别"
}AI返回后执行:点击后面的按钮,如下图:
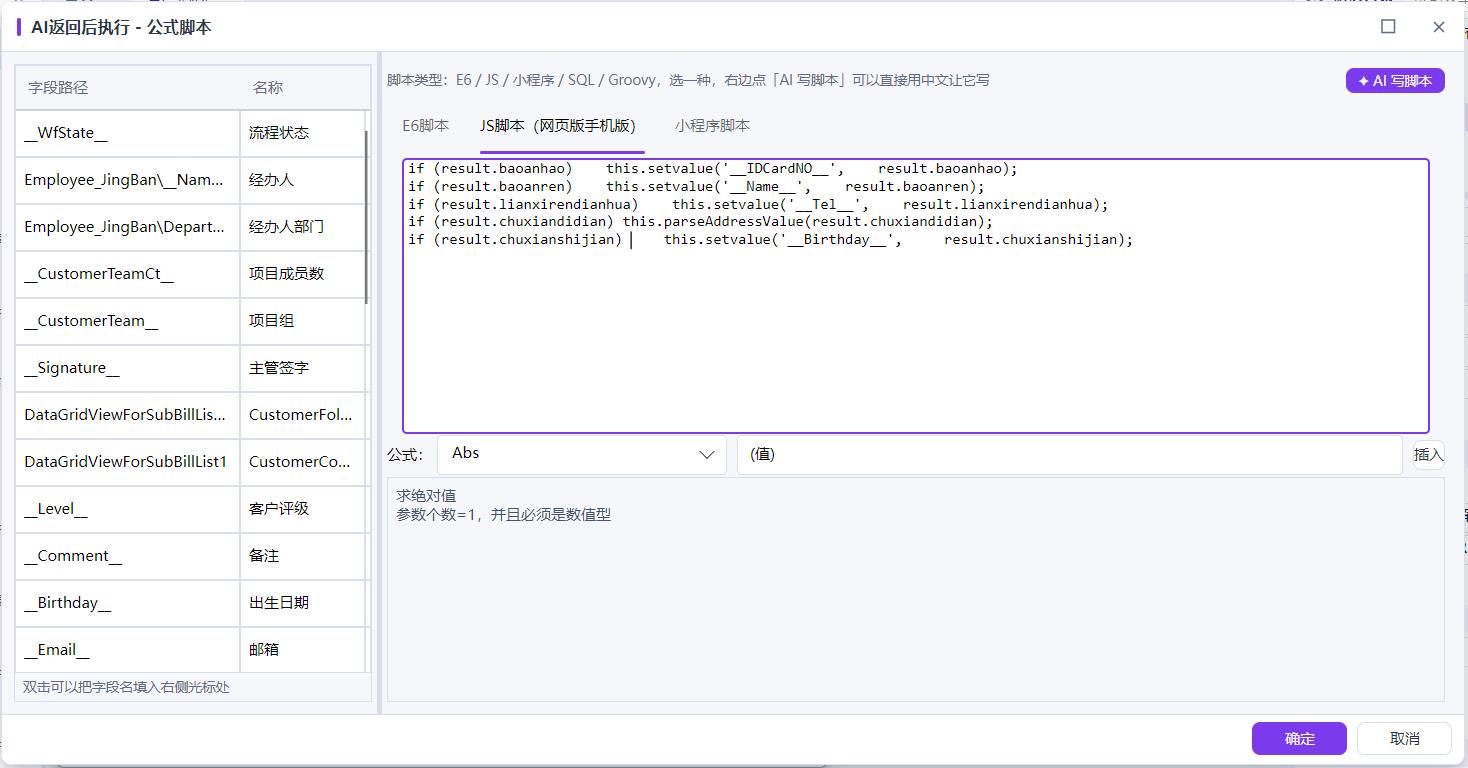
内容如(由于我们在前面AI提示词中已经要求AI按我们所需要的JSON格式进行返回了,所以这里使用result就可以获得返回的JSON格式):
if (result.baoanhao)    this.setvalue('__IDCardNO__',    result.baoanhao);
if (result.baoanren)    this.setvalue('__Name__',    result.baoanren);
if (result.lianxirendianhua)    this.setvalue('__Tel__',    result.lianxirendianhua);
if (result.chuxiandidian) this.parseAddressValue(result.chuxiandidian);
if (result.chuxianshijian)     this.setvalue('__Birthday__',     result.chuxianshijian);
设置完保存发布后,在客户端输入框中就会出现一个Ai按钮,点击就可以调大模型解析文本回填到表单字段: