调大模型接口实现证件识别
以前我们要做证件识别,只能调特定的云服务接口,这种云服务接口的特点就是接口固定,返回值固定,所以我们的证件识别服务就只能是绑定的。但是现在E6内置了大模型调用服务,所以我们完全可以通过大模型(视觉模型,如果不知道哪个大模型的视觉模型可以直接问大模型)。
另外调用大模型相对于证件识别云服务有如下优点:
1、更省钱:比如识别一张身份证/行驶证/驾驶证,云服务大概在3-5分钱一次,而大模型(测试用deepseek视觉模型)小于1分钱;
2、可以在提示词中要求AI按指定格式返回,而证件识别云服务返回值格式固定,导致不够灵活;
3、可以在提示词中要求AI补充一些数据,比如一些卡片信息地址没有包括省,市,可以要求AI补充完整,或者要求AI按我们需要的日期格式返回日期等等。
假设我们要给某个输入框假设证件识别功能:
1、修改配置文件:config/application.yml 设置大模型,设置vision-model参数,如下:
ai:
  api:
    url: https://api.deepseek.com/chat/completions
    key: 这里填deepseek的key,可在上面注释这里的网址中创建APIkey后填入
    model: deepseek-v4-pro
    # 识图 / OCR 专用模型。deepseek-v4-pro 是纯文本模型,不接受图片输入;
    # DeepSeek 官方支持图像理解的是 deepseek-flash(模型版本 DeepSeek-V4.1-Flash-1017)。
    # 依据:api-docs.deepseek.com/zh-cn/quick_start/pricing 的「图像理解」一行。
    vision-model: deepseek-flash
2、打开E6开发平台,假设我们需要在某个输入框后面能够有证件识别功能,则点中这个输入框,在右侧属性“所有”页下找到“证件识别”:
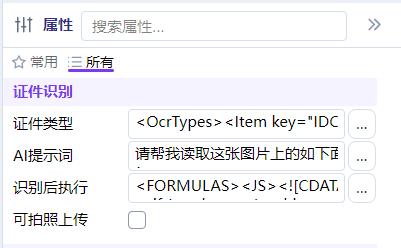
证件类型:
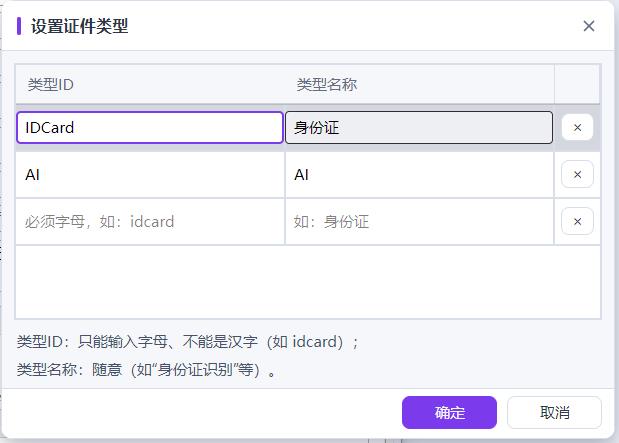
点击“证件类型”属性后面的按钮,设置证件类型:
类型ID:只能是字母,不能是汉字;
类型名称:随意
AI提示词:
点击“AI提示词”后面的按钮,输入提示词,提示词中一定要约定好返回格式(JSON格式),不约定的话AI处理后没法回填:
请帮我读取这张图片上的如下面返回值所需要的这些信息,返回如下JSON格式的数据,如果识别出的“地址”中没包含省市区,请补充完整,日期全部是yyyy-MM-dd格式,没有的字段不返回:
{
    name: "姓名",
    cardno: "证件号码",
    address: "地址,如果地址没包含省市区,请补充完整",
    tel: "电话",
    email: "邮箱",
    birthday: "出生日期,请返回yyyy-MM-dd格式",
    gender: "性别,男,女"
}
识别后执行:
点击“识别后执行”后面的按钮,在弹出“识别后执行”的JS脚本页中输入脚本,如果涉及到多种证件类型,可以根据类型ID进行判断,取值后填入表单字段。
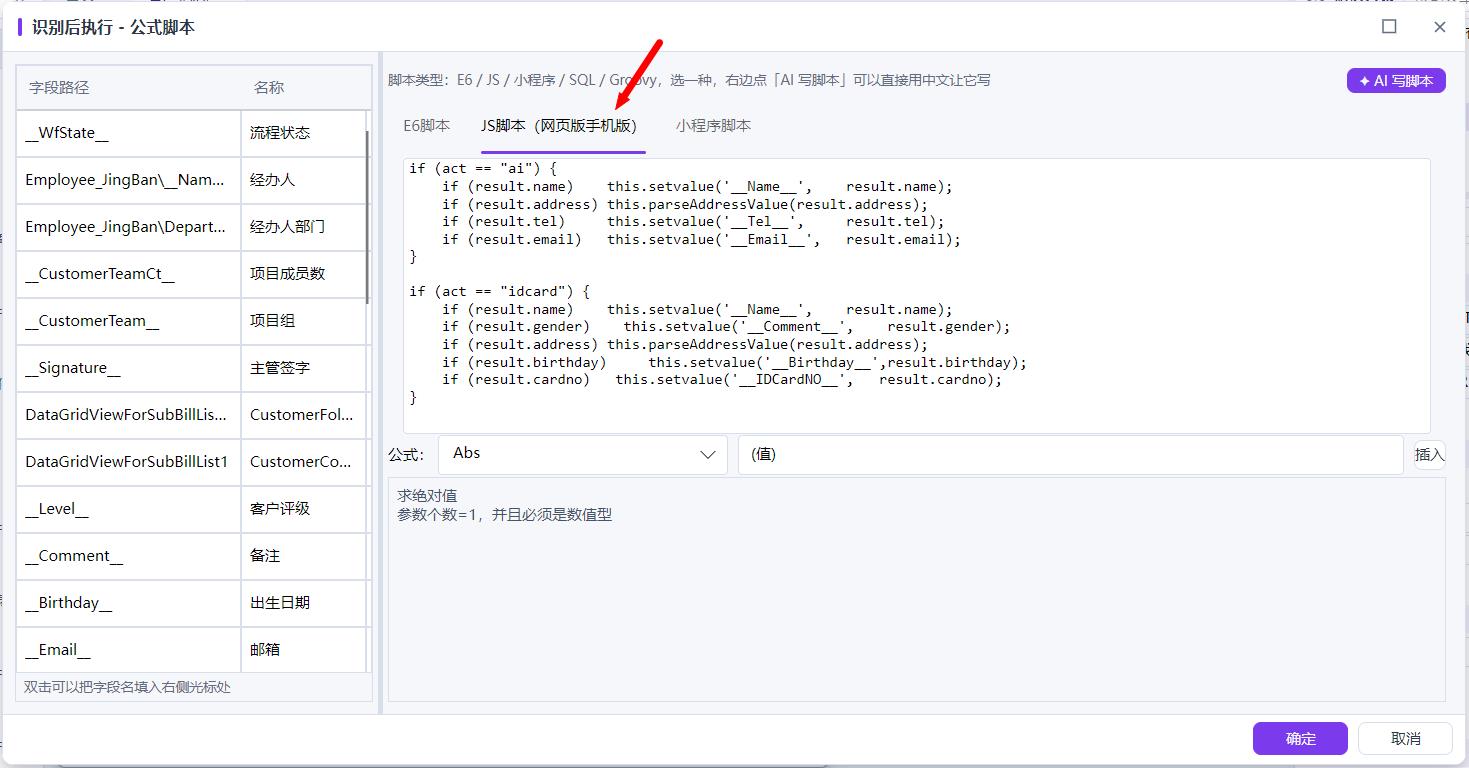
脚本如下,由于我们在前面AI提示词中已经要求AI按我们所需要的JSON格式进行返回了,所以这里使用result就可以获得返回的JSON格式:
if (act == "ai") {
    if (result.name)    this.setvalue('__Name__',    result.name);
    if (result.address) this.parseAddressValue(result.address);
    if (result.tel)     this.setvalue('__Tel__',     result.tel);
    if (result.email)   this.setvalue('__Email__',   result.email);
}

if (act == "idcard") {
    if (result.name)    this.setvalue('__Name__',    result.name);
    if (result.gender)    this.setvalue('__Comment__',    result.gender);
    if (result.address) this.parseAddressValue(result.address);
    if (result.birthday)     this.setvalue('__Birthday__',result.birthday);
    if (result.cardno)   this.setvalue('__IDCardNO__',   result.cardno);
}
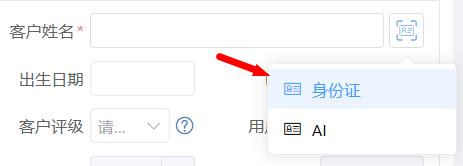
设置好之后,发布,登录客户端就可以看到这个输入框后面有OCR按钮,点击后可以上传图片进行识别,AI识别后会按我们提示词中的约定返回,然后调返回后执行JS回填到表单字段中。